Koszty AI w produkcji: jak zoptymalizować wydatki na OpenAI i Gemini
Ceny za token modeli zamkniętych i otwartych potrafią różnić się ponad 25-krotnie. Poznaj strategie kierowania zapytań, buforowania i kompresji, które mogą radykalnie obniżyć rachunki.
Stan faktyczny: dlaczego koszty AI wymykają się spod kontroli
Różnica w kosztach między modelami flagowymi a modelami o otwartych wagach osiągnęła punkt krytyczny. Weźmy obciążenie rzędu 1 miliona zgłoszeń wsparcia miesięcznie, średnio 150 tokenów wejściowych i 200 wyjściowych. Według cenników GPT-5.2 kosztuje za to ok. $3 060 miesięcznie, a DeepSeek V3.2 na DeepInfra ok. $115 – różnica ok. 27x[7][9]. To nie jest marginalna obniżka, tylko fundamentalna zmiana ekonomiki AI w produkcji.
Modele o otwartych wagach przestały być eksperymentem. W badaniu a16z i OpenRouter obejmującym ponad 100 bilionów tokenów odpowiadały za mniej więcej jedną trzecią ruchu obsługiwanego przez OpenRouter, a prym wiodły DeepSeek, Qwen, Kimi K2 i GLM[6]. Zespoły już nie tylko testują otwarte modele – używają ich na dużą skalę.
Problem nr 1: Kierowanie na ślepo
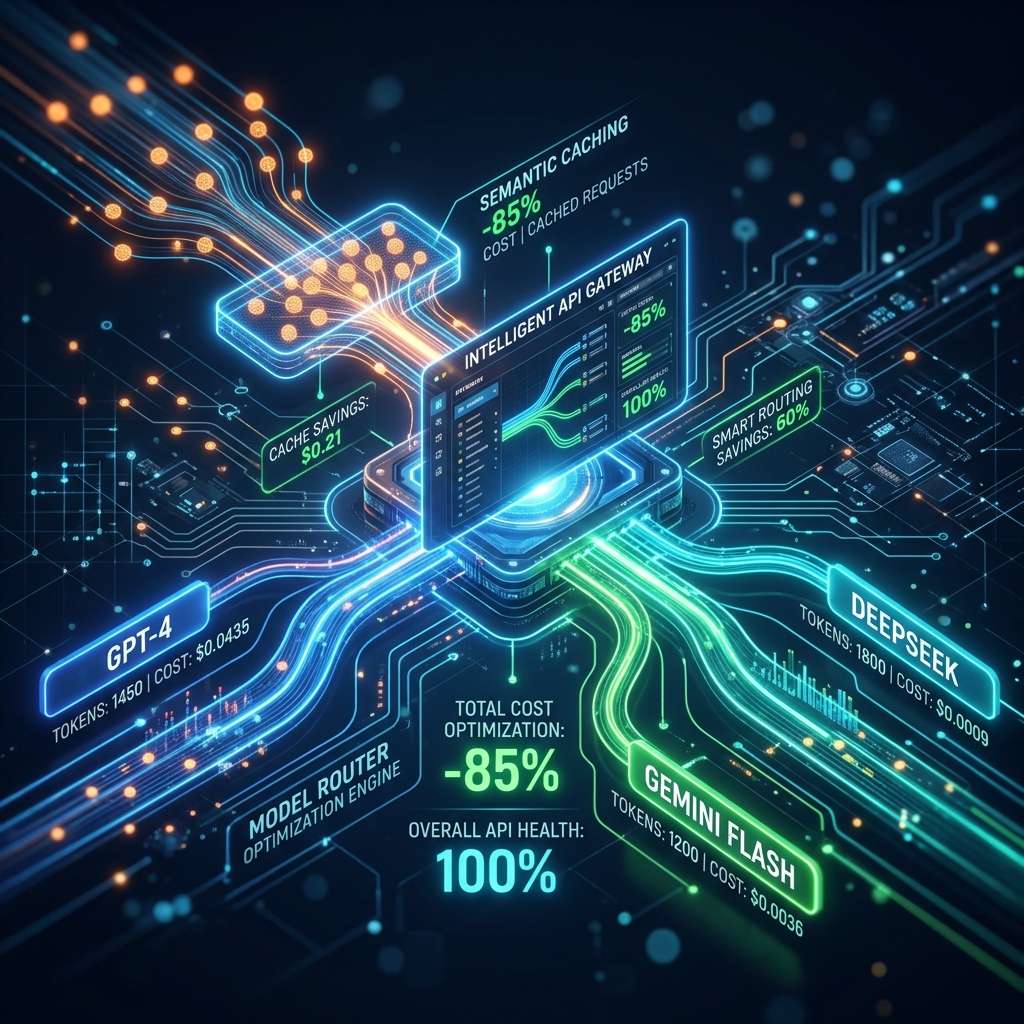
Wiele zespołów wysyła wszystko do najmocniejszego modelu, bo "działa". Tymczasem w wielu aplikacjach duża część zapytań to prosta klasyfikacja, ekstrakcja danych czy podstawowe wnioskowanie – zadania, które Gemini Flash-Lite obsłuży za ułamek ceny. W eksperymentach LMSYS router RouteLLM obniżył koszty o ponad 85% w teście MT Bench, zachowując 95% jakości GPT-4; w MMLU oszczędność wyniosła 45%[1].
Kluczowa lekcja: kierowanie zapytań nie polega na wyborze tańszego modelu – chodzi o dopasowanie złożoności zadania do możliwości modelu. Większość zadań nie potrzebuje GPT-4.
Problem nr 2: Płacenie za ten sam kontekst wielokrotnie
Typowy automatyczny asystent wsparcia technicznego wysyła tę samą instrukcję systemową i dokumentację produktu w każdym zapytaniu. To setki tysięcy tokenów dziennie za identyczną treść. Buforowanie kontekstu nalicza za powtarzane wejście ułamek normalnej stawki – na przykład zbuforowane tokeny wejściowe w rodzinie GPT-5 od OpenAI są o 90% tańsze, a Gemini stosuje buforowanie automatycznie w modelach 2.5 i nowszych[5]. Google oferuje też tryb Flex – o 50% tańszy od standardowego API w zamian za zmienne opóźnienia i dostępność w trybie „best effort"[3].
Tryb wsadowy to kolejna dźwignia dla niepilnych zadań. Jeśli raport może poczekać 2 godziny, nie ma sensu płacić za wnioskowanie w czasie rzeczywistym.
Problem nr 3: Nadmiarowe wywołania API
Buforowanie semantyczne (np. GPTCache, Redis) eliminuje powtarzające się zapytania całkowicie – jeszcze przed ich wysłaniem do API. Użytkownik pyta "jak zresetować hasło" w 50 wariantach językowych – pamięć podręczna zwraca tę samą odpowiedź bez zużycia ani jednego tokenu. To ostatnia linia obrony przed kosztami wymykającymi się spod kontroli.
Dodatkowa optymalizacja: kompresja zapytań. Microsoft podaje, że LLMLingua potrafi skrócić prompt nawet 20-krotnie przy minimalnej utracie jakości[2]. Mniej tokenów oznacza mniejszy rachunek.
Trzy kluczowe dźwignie w praktyce:
- Kierowanie zapytań: model flagowy tylko tam, gdzie rzeczywiście jest potrzebny. Reszta ruchu → Flash-Lite lub DeepSeek.
- Buforowanie kontekstu: Instrukcje systemowe, dokumentacja, długie teksty – buforuj agresywnie.
- Buforowanie semantyczne: Eliminuj nadmiarowe wywołania przed dotarciem do API.
Rozsądną zasadą domyślną jest start od szybkiego, taniego modelu, takiego jak Gemini Flash, i przejście na model klasy Pro dopiero wtedy, gdy widać konkretną lukę w jakości. Modele flagowe warto zostawić dla zadań, które ich naprawdę wymagają, a sporą część pozostałego ruchu można przenieść na otwarte modele na platformach bezserwerowych.
Modele rozumujące (takie jak Gemini 2.5 Flash z myśleniem czy GPT-5) dodają nowy wymiar. Większy budżet na rozumowanie nie oznacza automatycznie lepszych odpowiedzi, a długie rozumowanie może trwać minuty zamiast sekund. Wysiłek trzeba dopasować do faktycznych wymagań co do opóźnień i jakości – i zmierzyć go na własnych zadaniach.
Podsumowując: koszty sztucznej inteligencji wymykają się spod kontroli, ponieważ zespoły optymalizują za późno – dopiero gdy rachunek przekroczy budżet. Kierowanie zapytań, buforowanie i kompresja to nie są opcjonalne dodatki. To podstawa każdego wdrożenia produkcyjnego.
Kierowanie zapytań: inteligentne przesyłanie do tańszych modeli
W produkcji liczy się ekonomika jednostkowa. Gdy Twoja aplikacja obsługuje dziesiątki tysięcy zapytań dziennie, różnica między $1.75 a $0.26 za milion tokenów to nie zaokrąglenie w arkuszu kalkulacyjnym – to decyzja między rentownością a spalaniem kapitału. Inteligentne kierowanie zapytań pozwala wykorzystać tę różnicę bez kompromisów w doświadczeniu użytkownika.
Jak działa inteligentne kierowanie zapytań
Koncepcja jest prosta: nie każde zapytanie wymaga modelu flagowego. Klasyfikacja emocji w tekście? Gemini Flash-Lite. Ekstrakcja danych z faktury? Mały, tani model. Złożone wnioskowanie prawne? Dopiero wtedy sięgasz po model flagowy. RouteLLM obniżył koszty o ponad 85% przy zachowaniu 95% jakości GPT-4 w MT Bench i o 45% w MMLU[1].
Kluczem jest klasyfikator umieszczony przed głównym modelem. Analizuje on złożoność zapytania – długość, obecność słów kluczowych, strukturę – i kieruje je do odpowiedniego poziomu wydajnościowego. W praktyce 70-80% ruchu trafia do tańszych modeli, a za opcję premium płacisz tylko tam, gdzie to naprawdę konieczne.
Ekonomia wyboru: liczby z produkcji
Weźmy konkretny przykład: 1 000 000 zgłoszeń wsparcia technicznego miesięcznie, średnio 150 tokenów wejściowych i 200 wyjściowych – łącznie 150 mln tokenów wejściowych i 200 mln wyjściowych. Według cenników GPT-5.2 to ok. $3 060 miesięcznie. DeepSeek V3.2 przez DeepInfra? Ok. $115 – mniej więcej 27x taniej. Gemini 2.5 Pro plasuje się pośrodku z kosztem ok. $2 190[7][8][9].
┌─────────────────┬──────────┬───────────┬──────────────┐
│ Model           │ Wejście  │ Wyjście   │ Koszt/mies.  │
├─────────────────┼──────────┼───────────┼──────────────┤
│ GPT-5.2         │ $1.75/1M │ $14.00/1M │ ~$3,060      │
│ Gemini 2.5 Pro  │ $1.25/1M │ $10.00/1M │ ~$2,190      │
│ DeepSeek V3.2   │ $0.26/1M │ $0.38/1M  │ ~$115        │
└─────────────────┴──────────┴───────────┴──────────────┘
Modele o otwartych wagach obsługują już ok. jednej trzeciej ruchu na OpenRouter, a wśród najczęściej używanych są DeepSeek, Qwen i Kimi K2[6]. W przeliczeniu na token różnica między GPT-5.2 a DeepSeek V3.2 z powyższej tabeli wynosi ok. 7x na wejściu i ok. 37x na wyjściu.
LiteLLM jako uniwersalna bramka
Teoretycznie możesz budować system kierowania od zera. Praktycznie? Lepiej użyć LiteLLM. To ujednolicona bramka API, która normalizuje interfejsy OpenAI, Anthropic, Google, Azure i ponad 100 innych dostawców. Pozwala w jednym miejscu wdrożyć limity budżetowe, reguły kierowania i logikę awaryjną.
Konfiguracja wygląda następująco:
from litellm import completion

# Automatyczne kierowanie w zależności od złożoności zapytania
response = completion(
    model="gpt-5.2" if complexity_score > 0.7 else "gemini-2.5-flash-lite",
    messages=[{"role": "user", "content": prompt}],
    max_budget=0.05  # sztywny limit kosztu na zapytanie
)
LiteLLM obsługuje również buforowanie semantyczne (np. z użyciem Redis), które można łączyć z buforowaniem kontekstu po stronie dostawcy – ponownym wykorzystaniem instrukcji systemowych i dokumentacji z dużym rabatem. Pozwala to wyeliminować zbędne wywołania, zanim w ogóle trafią do API.
Kiedy płacić za wersję premium
Są scenariusze, w których model flagowy zwraca się natychmiast. Dobrą zasadą pozostaje start od modelu klasy Flash i przejście wyżej dopiero wtedy, gdy widać konkretne braki w jakości. Przykłady:
- Złożone wnioskowanie: Claude Opus, GPT-5.x, Gemini Pro – gdy niezbędna jest wieloetapowa logika.
- Krytyczna dokładność: medycyna, prawo, finanse – gdzie koszt ewentualnego błędu jest znacznie wyższy niż koszt tokenów.
- Wizerunek marki: asystent obsługujący klientów znanej firmy nie może brzmieć jak prosty bot sprzed lat.
Większy budżet na rozumowanie nie zawsze poprawia wyniki, a zapytania wymagające długiego rozumowania potrafią trwać minuty. Dopasuj wysiłek do faktycznych wymagań co do opóźnień i zmierz zysk na własnych testach.
Kierowanie zapytań to nie tylko drobna optymalizacja – to kluczowa decyzja architektoniczna. Przy dużej skali różnica między wysyłaniem wszystkiego do modelu flagowego a inteligentnym kierowaniem może sięgać dziesiątek tysięcy dolarów rocznie. I to bez zauważalnego obniżenia jakości dla użytkownika końcowego.
Buforowanie kontekstu i buforowanie semantyczne: eliminacja nadmiarowych kosztów
Największym marnotrawstwem budżetu w systemach sztucznej inteligencji jest wielokrotne przesyłanie tych samych danych. Typowy system wysyła tę samą długą instrukcję systemową setki razy dziennie, płacąc za każdy token. Buforowanie kontekstu rozwiązuje ten problem – zamiast płacić pełną stawkę za cały kontekst przy każdym wywołaniu, dostawca ponownie wykorzystuje zbuforowany początek zapytania i nalicza za niego mocno obniżoną stawkę (w rodzinie GPT-5 od OpenAI o 90% niższą)[5].
Mechanizm działa bardzo prosto: pierwsze zapytanie z długim kontekstem (np. dokumentacją API, regułami biznesowymi czy przykładowymi odpowiedziami) jest buforowane po stronie dostawcy, a kolejne zapytania zaczynające się od tego samego fragmentu płacą obniżoną stawkę. Gemini domyślnie włącza takie buforowanie niejawne w modelach 2.5 i nowszych, a dodatkowo pozwala tworzyć bufory jawnie[5]. OpenAI automatycznie buforuje długie, powtarzające się początki zapytań. Aktualny rabat dla konkretnego modelu sprawdzaj w cenniku dostawcy.
Buforowanie semantyczne idzie jeszcze o krok dalej – pozwala całkowicie uniknąć wysyłania zapytań do modeli zewnętrznych. Zamiast porównywać zapytania znak po znaku, narzędzia takie jak GPTCache wykorzystują wektory reprezentacji semantycznej do wykrywania pytań o identycznym znaczeniu. Pytanie "Jak zresetować hasło?" i "W jaki sposób mogę zmienić moje hasło na nowe?" zostaną uznane za semantycznie tożsame. Wdrożenie bazy danych Redis jako warstwy pamięci podręcznej przed API umożliwia natychmiastowe zwrócenie odpowiedzi bez uruchamiania modelu i ponoszenia kosztów.
Różnica między tymi dwoma podejściami jest zasadnicza: buforowanie kontekstu obniża koszt pojedynczego wywołania (przetwarzamy mniej tokenów), natomiast buforowanie semantyczne eliminuje wywołanie w ogóle (nie wysyłamy zapytania, uzyskując zerowe opóźnienie). W praktyce najlepiej stosować obie metody równolegle: buforować długie teksty instrukcji i jednocześnie sprawdzać, czy podobne pytanie użytkownika nie zostało już wcześniej obsłużone.
Typowy zestaw technologiczny wygląda tak: Redis jako warstwa semantycznej pamięci podręcznej → buforowanie kontekstu u dostawcy API → kompresja zapytań za pomocą LLMLingua (nawet 20x mniej tokenów)[2] → kierowanie prostych zapytań do tańszych modeli. Wielkość oszczędności zależy mocno od tego, jak powtarzalny jest Twój ruch, więc zmierz ją przed wdrożeniem i po nim.
Wdrożenie wymaga zaplanowania strategii unieważniania pamięci podręcznej. Buforowany kontekst ma swój czas życia (zazwyczaj od 5 do 60 minut), więc aktualizacje dokumentacji muszą wymuszać jego odświeżenie. Buforowanie semantyczne z kolei wymaga ustalenia odpowiedniego progu podobieństwa. Zbyt wysoki próg (>0,95) sprawi, że system nie rozpozna podobnych pytań, natomiast zbyt niski (<0,85) może spowodować zwrócenie nieadekwatnej odpowiedzi. W praktycznych wdrożeniach optymalny punkt to 0,90-0,92 dla wsparcia klientów oraz 0,93-0,95 dla zapytań technicznych.
Monitorowanie wydatków po uruchomieniu buforowania zwykle pokazuje podobny wzorzec: na początku współczynnik trafień jest niski (pamięć podręczna się zapełnia), a potem stabilizuje się na poziomie zależnym od tego, jak powtarzalne są pytania użytkowników. Najwięcej zyskują boty wsparcia klienta, mniej – narzędzia wewnętrzne.
Modele o otwartym kodzie vs modele zamknięte: analiza kosztów w liczbach
Różnica między GPT-5.2 a DeepSeek V3.2 nie jest teoretyczna – wynika wprost z cenników. Przy obsłudze 1 miliona zgłoszeń wsparcia miesięcznie (po 150 tokenów wejściowych i 200 wyjściowych) GPT-5.2 generuje rachunek ok. $3 060, Gemini 2.5 Pro ok. $2 190, a DeepSeek V3.2 przez DeepInfra ok. $115[7][8][9].
Kluczowe metryki kosztowe:
| Model | Wejście ($/1M tokenów) | Wyjście ($/1M tokenów) | Koszt miesięczny (1 mln zapytań) |
|---|---|---|---|
| GPT-5.2 | $1.75 | $14.00 | ~$3 060 |
| Gemini 2.5 Pro | $1.25 | $10.00 | ~$2 190 |
| DeepSeek V3.2 | $0.26 | $0.38 | ~$115 |
Ceny katalogowe z momentu pisania – przed planowaniem budżetu sprawdź aktualne cenniki dostawców.
Różnica jakościowa? Często mniejsza, niż mogłoby się wydawać. W wielu zadaniach produkcyjnych (klasyfikacja zgłoszeń, ekstrakcja danych, odpowiedzi na FAQ) dobry otwarty model w zupełności wystarcza – ale sprawdź to na własnym zbiorze testowym, a nie wyłącznie na publicznych benchmarkach.
Kiedy migracja się opłaca? Kalkulacja jest prosta: jeśli Twoje wydatki na model zamknięty przekraczają kilkaset dolarów miesięcznie, a zadania nie wymagają najwyższej jakości w każdym przypadku, przetestuj tańszy model. Nawet jeśli co piąte zapytanie musi trafić do modelu flagowego, łączny koszt wciąż może być kilkukrotnie niższy.
Infrastruktura bezserwerowa to kolejny przełom. Zamiast utrzymywać własne serwery z kartami GPU i płacić za czas ich bezczynności, płacisz wyłącznie za faktyczne wnioskowanie na platformach takich jak DeepInfra, Together.ai czy Replicate. Zero pracy DevOps, automatyczne skalowanie.
Strategia hybrydowa w praktyce: Wykorzystaj router, taki jak RouteLLM. Proste pytania trafiają do DeepSeek ($0.26 za milion tokenów wejściowych), średnio skomplikowane do Gemini Flash, a tylko najtrudniejsze do modelu flagowego. W eksperymentach LMSYS taki routing obniżył koszty o ponad 85% przy zachowaniu 95% jakości GPT-4 w MT Bench i o 45% w MMLU[1].
Modele o otwartych wagach przestały być eksperymentem – obsługują ok. jednej trzeciej ruchu na OpenRouter, z DeepSeek, Qwen i Kimi K2 na czele[6]. Firmy nie zastanawiają się już, „czy" warto je wdrożyć, lecz pytają, „jak szybko" mogą to zrobić.
Ostrzeżenia przed migracją: Jeśli Twój system wymaga zaawansowanego wnioskowania na poziomie najmocniejszych modeli (np. skomplikowane obliczenia matematyczne czy logika wieloetapowa), różnica w jakości odpowiedzi będzie zauważalna. Jeśli musisz spełniać surowe wymogi zgodności z regulacjami (np. HIPAA czy certyfikacja SOC2 u konkretnego dostawcy), wybór modeli z otwartym kodem może być ograniczony. W przypadku, gdy krytyczny jest czas odpowiedzi poniżej 500 ms, niektóre otwarte modele mogą nie zapewnić odpowiedniej szybkości.
Jednak dla standardowych zastosowań biznesowych – obsługi klientów, tworzenia treści czy wyciągania danych z dokumentów – różnica cen rzędu wielokrotności jest trudna do zignorowania, o ile własne testy pokażą akceptowalną jakość.
Zaawansowane techniki: Flex Inference, Batch Mode i kompresja zapytań
W systemach produkcyjnych liczy się każdy grosz wydany na tokeny, dlatego warto wdrożyć bardziej zaawansowane metody. Poniżej opisuję trzy techniki pozwalające znacząco obniżyć koszty, o ile właściwie ocenimy ich wady i zalety.
Flex Inference: połowa ceny za większe opóźnienie
Tryb Flex w Gemini API, wprowadzony w kwietniu 2026 roku, to synchroniczna opcja zoptymalizowana pod kątem kosztów – płacisz 50% standardowej ceny w zamian za zmienne opóźnienia i dostępność w trybie „best effort"[3]. To dobra oferta, ale tylko dla zadań, które nie wymagają odpowiedzi w czasie rzeczywistym: nocnych analiz, raportów czy wzbogacania danych offline. Dla chatbotów obsługujących klientów na żywo – zapomnij.
Kluczowa decyzja: czy Twój system toleruje zmienny czas odpowiedzi. Jeśli tak, skierowanie części ruchu do usługi Flex obniży rachunki bez konieczności modyfikowania kodu aplikacji.
Tryb wsadowy: rabat za cierpliwość
Tryb wsadowy polega na uzyskaniu stałego rabatu w zamian za zgodę na opóźnione wykonanie zadania. Batch API od OpenAI kosztuje o 50% mniej i zwraca wyniki w ciągu 24 godzin[4]; Gemini oferuje podobny tryb. Klasyczne przykłady to tworzenie wektorów dla całej bazy wiedzy, ocena leadów z CRM czy podsumowania logów. Zamiast płacić pełną stawkę za każde wywołanie, pakujesz zadania i uruchamiasz je asynchronicznie.
Wymaga to jednak modyfikacji architektury – nie wystarczy przełączyć synchronicznego endpointu na tryb wsadowy. Należy zbudować kolejkę zadań, obsługę ponowień i mechanizm powiadomień o zakończeniu.
Kompresja zapytań: 20-krotne zmniejszenie liczby tokenów
Narzędzie LLMLingua potrafi skompresować zapytania nawet 20-krotnie, co bezpośrednio przekłada się na mniejszą liczbę tokenów wejściowych wysyłanych do API[2]. Działa to dzięki małemu modelowi językowemu, który usuwa najmniej istotne tokeny, zachowując sens.
Przykład: zamiast przesyłać za każdym razem 10 000 tokenów dokumentacji, kompresujesz tekst do 500 tokenów. Przy 100 000 wywołań miesięcznie to 1 miliard zamiast 50 milionów tokenów wejściowych – ok. $1 750 zamiast $87,50 przy stawce GPT-5.2 wynoszącej $1.75 za milion tokenów wejściowych. Haczyk? Musisz utrzymywać model kompresujący (jest open source) i dodajesz pewne opóźnienie przed każdym wywołaniem API.
Budżet na rozumowanie: więcej nie oznacza lepiej
Modele o zaawansowanych zdolnościach rozumowania mogą myśleć dłużej, ale to kosztuje – zarówno w tokenach, jak i w czasie, w przypadku złożonych zadań nawet minuty na zapytanie. Większy budżet na rozumowanie nie oznacza automatycznie lepszych odpowiedzi.
Praktyczna wskazówka: nie ustawiaj maksymalnego budżetu na rozumowanie "na zapas". Rozpocznij od 16k tokenów, zmierz skuteczność na własnych testach i zwiększaj limit tylko wtedy, gdy przynosi to realny wzrost dokładności. Znam projekty, w których zespoły płaciły dwukrotnie więcej za zaawansowane wnioskowanie, które poprawiało dokładność odpowiedzi o zaledwie 1% – ekonomicznie było to nieuzasadnione.
Ta sama filozofia dotyczy wyboru modelu: zacznij od szybkiego, taniego modelu, takiego jak Gemini Flash, a na wersję Pro przejdź tylko wtedy, gdy naprawdę jej potrzebujesz. Płać za to, czego faktycznie używasz, a nie za to, co efektownie wygląda w konfiguracji.
Zarządzanie w skali przedsiębiorstwa: od AI Studio do Vertex AI
W dużych firmach brak kontroli nad kluczami API i wydatkami to częsty problem. Zespoły korzystają z bezpłatnego Google AI Studio do tworzenia prototypów, po czym przenoszą rozwiązania na produkcję i okazuje się, że nikt nie monitoruje kosztów generowanych przez poszczególne działy. Przejście z AI Studio do platformy Gemini Enterprise Agent Platform zapewnia pełną kontrolę zarządczą, ale wymaga wdrożenia architektury, która nie wymusi przepisywania aplikacji od nowa.
Narzędzie Portkey działa jako bramka API ze śledzeniem wydatków na żywo w rozbiciu na modele i zespoły. Od razu widzisz, że zespół A wydaje większość budżetu na model flagowy, choć wiele jego zapytań mógłby obsłużyć Flash-Lite. Portkey loguje każde wywołanie, więc masz ślad audytowy i możesz ustawić alerty po przekroczeniu progu.
Yotta AI Gateway to jednolita warstwa dostępu – piszesz kod pod jedno API, a pod spodem możesz przełączać się między OpenAI, Gemini i Claude bez zmian w aplikacji. W dużych organizacjach to ważne, bo nie jesteś uzależniony od jednego dostawcy i możesz testować nowe modele bez refaktoryzacji. Buforowanie semantyczne na poziomie bramki eliminuje zbędne wywołania całkowicie.
Przy bardzo dużej skali wdrożeń niezbędna staje się gwarantowana przepustowość. Dostawcy tacy jak OpenAI czy Google oferują dedykowaną moc obliczeniową o stałym czasie odpowiedzi – płacisz stałą kwotę z góry za dostępną wydajność, a nie za każdy przesłany token. Przy wolumenach rzędu ponad 10 milionów tokenów miesięcznie, takie rozwiązanie bywa tańsze niż standardowe rozliczenie za zużycie i gwarantuje przewidywalność kosztów. Kontrolę budżetu konfiguruje się w usłudze Vertex AI: ustawiasz sztywny limit na zespół, ostrzeżenie po zużyciu 80% środków oraz automatyczne dławienie zapytań po przekroczeniu budżetu. Bez takich zabezpieczeń w firmie zatrudniającej setki osób ryzykujesz, że ktoś uruchomi błędny proces wsadowy na najdroższym modelu i zużyje cały miesięczny budżet w jeden weekend.
Praktyczny framework decyzyjny i lista kontrolna optymalizacji
Gdy miesięczne koszty API wynoszą $5,000, możesz przymknąć oko na brak optymalizacji. Przy $50,000 to już poważny problem biznesowy. Granicą, po przekroczeniu której należy podjąć działania, jest moment, gdy wydatki na API sztucznej inteligencji zaczynają stanowić ponad 15% budżetu na badania i rozwój (R&D).
Pięciostopniowa lista kontrolna optymalizacji:
-
Audyt tokenów (tydzień 1): Zidentyfikuj 20% punktów końcowych, które odpowiadają za 80% wszystkich kosztów. Zbadaj średnią długość zapytań, częstotliwość wywołań oraz proporcje używanych modeli.
-
Szybkie zyski – buforowanie (tydzień 2-3): Wdróż buforowanie kontekstu dla powtarzających się instrukcji systemowych. Jeśli w każdym wywołaniu przesyłasz dokumentację produktu, buforowanie może radykalnie obniżyć koszt tych tokenów[5]. Dodaj buforowanie semantyczne (np. Redis) dla powtarzających się pytań użytkowników.
-
Kierowanie zapytań (tydzień 4-6): Kieruj proste zadania do Gemini Flash-Lite lub DeepSeek V3.2 na DeepInfra. W powyższym przykładzie przeniesienie obciążenia z GPT-5.2 na DeepSeek V3.2 obniża rachunek z ok. $3 060 do ok. $115 miesięcznie. Model flagowy zostaw dla złożonych przypadków brzegowych.
-
Przetwarzanie wsadowe (tydzień 7): Przenieś zadania, które nie wymagają natychmiastowej odpowiedzi, do trybu wsadowego lub Flex – ok. 50% taniej, kosztem zbudowania asynchronicznego potoku[3][4].
-
Monitorowanie i iteracja (proces ciągły): Stwórz panel kontrolny monitorujący trzy najważniejsze wskaźniki: koszt na zapytanie (cel: <$0,01 dla prostych zadań), współczynnik trafień pamięci podręcznej (cel: >60% po miesiącu pracy) oraz ocenę jakości (np. satysfakcja użytkowników – nie powinna spaść o więcej niż 5% w trakcie procesu optymalizacji).
Plan wdrożenia dla zespołów wydających $5,000 - $50,000 miesięcznie (orientacyjne cele – realne oszczędności mocno zależą od obciążenia):
- Miesiąc 1: Audyt i wdrożenie buforowania kontekstu → szacowana oszczędność rzędu 30-40%.
- Miesiąc 2: Przekierowanie 50% ruchu do tańszych modeli → dodatkowe 20-30% oszczędności.
- Miesiąc 3: Wdrożenie buforowania semantycznego i przetwarzania wsadowego → kolejne 15-20% oszczędności.
- Miesiąc 4+: Dostrojenie modeli o otwartym kodzie do specyficznych zastosowań oraz migracja na własną infrastrukturę dla największych wolumenów zapytań.
Kluczowa zasada: nie optymalizuj wszystkiego jednocześnie. Rozpocznij od miejsc generujących największe koszty, zmierz uzyskany efekt i dopiero wtedy przejdź do kolejnego kroku. Zespoły, które od razu próbują wdrażać własną infrastrukturę dla modeli Llama, często tracą 2-3 miesiące na kwestie techniczne, podczas gdy mogłyby zaoszczędzić 60% kosztów w jeden tydzień dzięki prostemu kierowaniu zapytań.
Weryfikuj swoją strategię co kwartał – ceny za dany poziom możliwości modeli szybko spadają, a nowe premiery potrafią zmienić ekonomikę z dnia na dzień. Rozwiązanie, które było najbardziej opłacalne w pierwszym kwartale, w trzecim może być już przestarzałe.
Bibliografia
- RouteLLM: An Open-Source Framework for Cost-Effective LLM Routing – LMSYS (lipiec 2024)
- LLMLingua: Innovating LLM efficiency with prompt compression – Microsoft Research
- New ways to balance cost and reliability in the Gemini API (Flex and Priority inference) – Google (kwiecień 2026)
- Batch API – OpenAI dokumentacja
- Context caching – Gemini API dokumentacja
- State of AI: An empirical 100 trillion token study with OpenRouter – a16z
- GPT-5.2 API pricing – Price Per Token
- Gemini API pricing – Google AI for Developers
- DeepSeek-V3.2 – DeepInfra
Komentarze
Komentarze obsługuje Cusdis. Widżet ładuje się dopiero po kliknięciu.