Analityka predykcyjna w SaaS: jak prognozowanie wspiera rozwój produktu
Rynek analityki predykcyjnej rośnie o około 20% rocznie, a uczenie maszynowe zmienia sposób planowania produktów SaaS. Co już działa, czego wciąż brakuje i od czego zacząć we własnym zespole.
Wprowadzenie: od pulpitów z wykresami do systemów decyzyjnych
Kolorowe pulpity analityczne (dashboardy) przestały wystarczać. Pokazują, co się wydarzyło, a zespół produktowy potrzebuje odpowiedzi na zupełnie inne pytanie: co zrobić dalej. Analityka predykcyjna przechodzi wyraźną przemianę. Z narzędzi do raportowania przeszłości staje się elementem podejmowania decyzji. Jak trafnie ujmuje to jedno z opracowań, firmy SaaS, które radzą sobie najlepiej, nie różnią się tym, czy używają AI, ale tym, czy prognozy faktycznie wpływają na decyzje w produkcie, finansach, obsłudze klienta i sprzedaży[6]. Najnowsze podejścia oparte na uczeniu maszynowym potrafią już przewidzieć wyniki nowego produktu w pierwszym i drugim roku po premierze, a przy okazji oszacować kanibalizację i realny wzrost netto[1].
To nie jest chwilowa moda. Rynek analityki predykcyjnej rośnie w tempie około 20% rocznie[2][4], a model subskrypcyjny sprawił, że ten poziom analityki jest dziś w zasięgu średnich firm, nie tylko korporacji. Zespoły produktowe nie chcą stawiać własnej infrastruktury. Chcą API, które podepnie się pod Mixpanela, Amplitude albo własną hurtownię danych i zwróci prognozę wtedy, kiedy jest potrzebna.
Najważniejsza zmiana dotyczy jednak samego pytania, które zadajemy danym. Zamiast „ilu klientów zrezygnowało w zeszłym miesiącu?" pytamy: „która grupa klientów jest najbardziej zagrożona odejściem w drugim kwartale i którą funkcję trzeba dopracować, żeby to zmienić?". Modele łączą wzorce korzystania z produktu, doświadczenia z wcześniejszych premier i dane rynkowe, żeby wesprzeć konkretne wybory: co trafia na plan rozwoju produktu, kiedy wypuścić nową wersję, ile pieniędzy przeznaczyć na rozwój. Raport staje się narzędziem do podejmowania decyzji (decision intelligence).
Nowe podejście do prognozowania produktów z użyciem AI i ML
Większość zespołów produktowych w SaaS wciąż traktuje prognozowanie jak lusterko wsteczne. Patrzy na historyczne metryki i przedłuża trend linią prostą. Kłopot w tym, że kiedy spadek retencji widać już w danych, rynek zdążył pójść dalej. Potrzebne są systemy, które oszacują popyt, zanim zespół zainwestuje kwartał pracy programistów.
Dobry przykład pokazano 14 września 2026 roku na konferencji Analytics and Forecasting 2026 organizowanej przez Marketing Science Institute w Nowym Jorku. Zespół Kenvue (koncern dóbr konsumenckich, właściciel m.in. marek Listerine i Neutrogena) razem z firmą Cloverpop przedstawił podejście do prognozowania popytu na nowe produkty oparte na uczeniu maszynowym[1]. Łączy ono w jednej platformie decyzyjnej zagregowane dane ze sprzedaży w punktach handlowych (POS), historię wcześniejszych premier, zmienne wykonawcze oraz atrybuty produktów wzbogacone przez AI. Na tej podstawie prognozuje wyniki pierwszego i drugiego roku, a jednocześnie szacuje kanibalizację i sprzedaż, która jest rzeczywiście nowa[1]. Autorzy podkreślają, że poza lepszą trafnością pozwala to szybciej oceniać koncepcje, symulować scenariusze i rzadziej sięgać po kosztowne badania konceptów[1].
To podejście wyrosło z handlu, ale łatwo przełożyć je na SaaS. Dowiadujemy się nie tylko, czy funkcja X będzie używana, ale też czy przyciągnie nowych klientów, czy po prostu podbierze użytkowników funkcji Y. Różnica w stosunku do klasycznych testów A/B jest zasadnicza: prognozę dostajesz przed napisaniem kodu, a nie po trzech miesiącach eksperymentu na połowie użytkowników.
Najwięcej daje to przy planowaniu rozwoju produktu. Zamiast specyfikacji opartej na opiniach klientów i intuicji menedżera produktu dostajesz liczby. Hipotetyczny wynik mógłby wyglądać tak: „Funkcja A: wzrost ARR o 12–18% w pierwszym roku, 8% kanibalizacji planu Enterprise, wzrost netto +4%". Decyzje o portfelu przestają być polityczne, bo model pokazuje, które inicjatywy przyniosą przychód, które zjedzą istniejące linie produktowe, a które okażą się grą o sumie zerowej.
Dla mnie to naturalny kolejny krok w analityce produktowej. Mixpanel i Amplitude mówią, co się stało. Nowa generacja narzędzi próbuje odpowiedzieć, co się stanie, jeśli. To różnica między analizą po fakcie a analizą przed decyzją, między reagowaniem a świadomym kształtowaniem wyniku.
Trzeba tylko pamiętać, że taki model potrzebuje danych: odpowiednio długiej historii premier, czystych danych o adopcji i rezygnacjach dla poszczególnych funkcji oraz połączenia z CRM i systemem rozliczeń. Firma SaaS po kilku latach działania zwykle ma to wszystko w jakimś systemie. Pytanie brzmi, czy używa tych danych do prognozowania, czy wyłącznie do tłumaczenia zarządowi, co nie wyszło w trzecim kwartale.
Dynamika rynku: liczby i tempo adopcji
Rynek analityki biznesowej dostarczanej w modelu SaaS rośnie szybko. Według Precedence Research w 2026 roku jest wart 16,42 mld USD, a do 2035 roku ma dojść do 60,52 mld USD. Daje to średnioroczny wzrost (CAGR) na poziomie 15,6%[3]. Analityka predykcyjna odpowiadała w 2025 roku za 35% tego rynku i ma rosnąć szybciej niż cała kategoria, w tempie 17,5% rocznie[3].
Szacunki dla całego rynku analityki predykcyjnej (nie tylko SaaS) zależą od źródła. Precedence Research mówi o wzroście z 21,24 mld USD w 2026 do 113,46 mld USD w 2035 przy CAGR 20,56%[2]. Fortune Business Insights podaje 27,56 mld USD w 2026 i 116,65 mld USD w 2034 przy CAGR 19,8%[4]. Rozbieżności wynikają z różnych definicji kategorii, ale kierunek jest jednoznaczny. Prognozowanie wychodzi z działów BI i trafia do zespołów produktowych, obsługi klienta i operacji przychodowych (RevOps).
Wyraźnie widać też, gdzie te narzędzia działają. Według Fortune Business Insights wdrożenia chmurowe mają w 2026 roku ponad 79% udziału w rynku analityki predykcyjnej[4]. Ciężkie instalacje na własnych serwerach, których integracja trwała miesiącami, ustępują platformom subskrypcyjnym. Dla małych i średnich firm to ogromna zmiana. Zamiast dużego budżetu na rozwiązanie szyte na miarę mogą zacząć od abonamentu i zwiększać skalę razem ze zwrotem z inwestycji.
Dostawcy nie konkurują już wyłącznie ceną. Wbudowują prognozy w narzędzia, z których menedżerowie produktu i zespoły RevOps korzystają codziennie. Dobrym przykładem jest Salesforce Einstein, powszechnie używany do oceny potencjału leadów i prognozowania szans sprzedażowych bezpośrednio w CRM[6]. Zamiast osobnego pulpitu „do analityki" ryzyko odejścia klienta widać w panelu opiekuna klienta, prognozę przychodu z rozszerzeń w CRM, a przewidywaną adopcję nowych funkcji w narzędziu do analityki produktowej. Moim zdaniem to właśnie ta integracja napędza popularność. Narzędzie, które jest w codziennym zestawie, wygrywa z najbardziej wyrafinowanym rozwiązaniem działającym gdzieś obok.
Najważniejsze zastosowania w rozwoju produktów SaaS
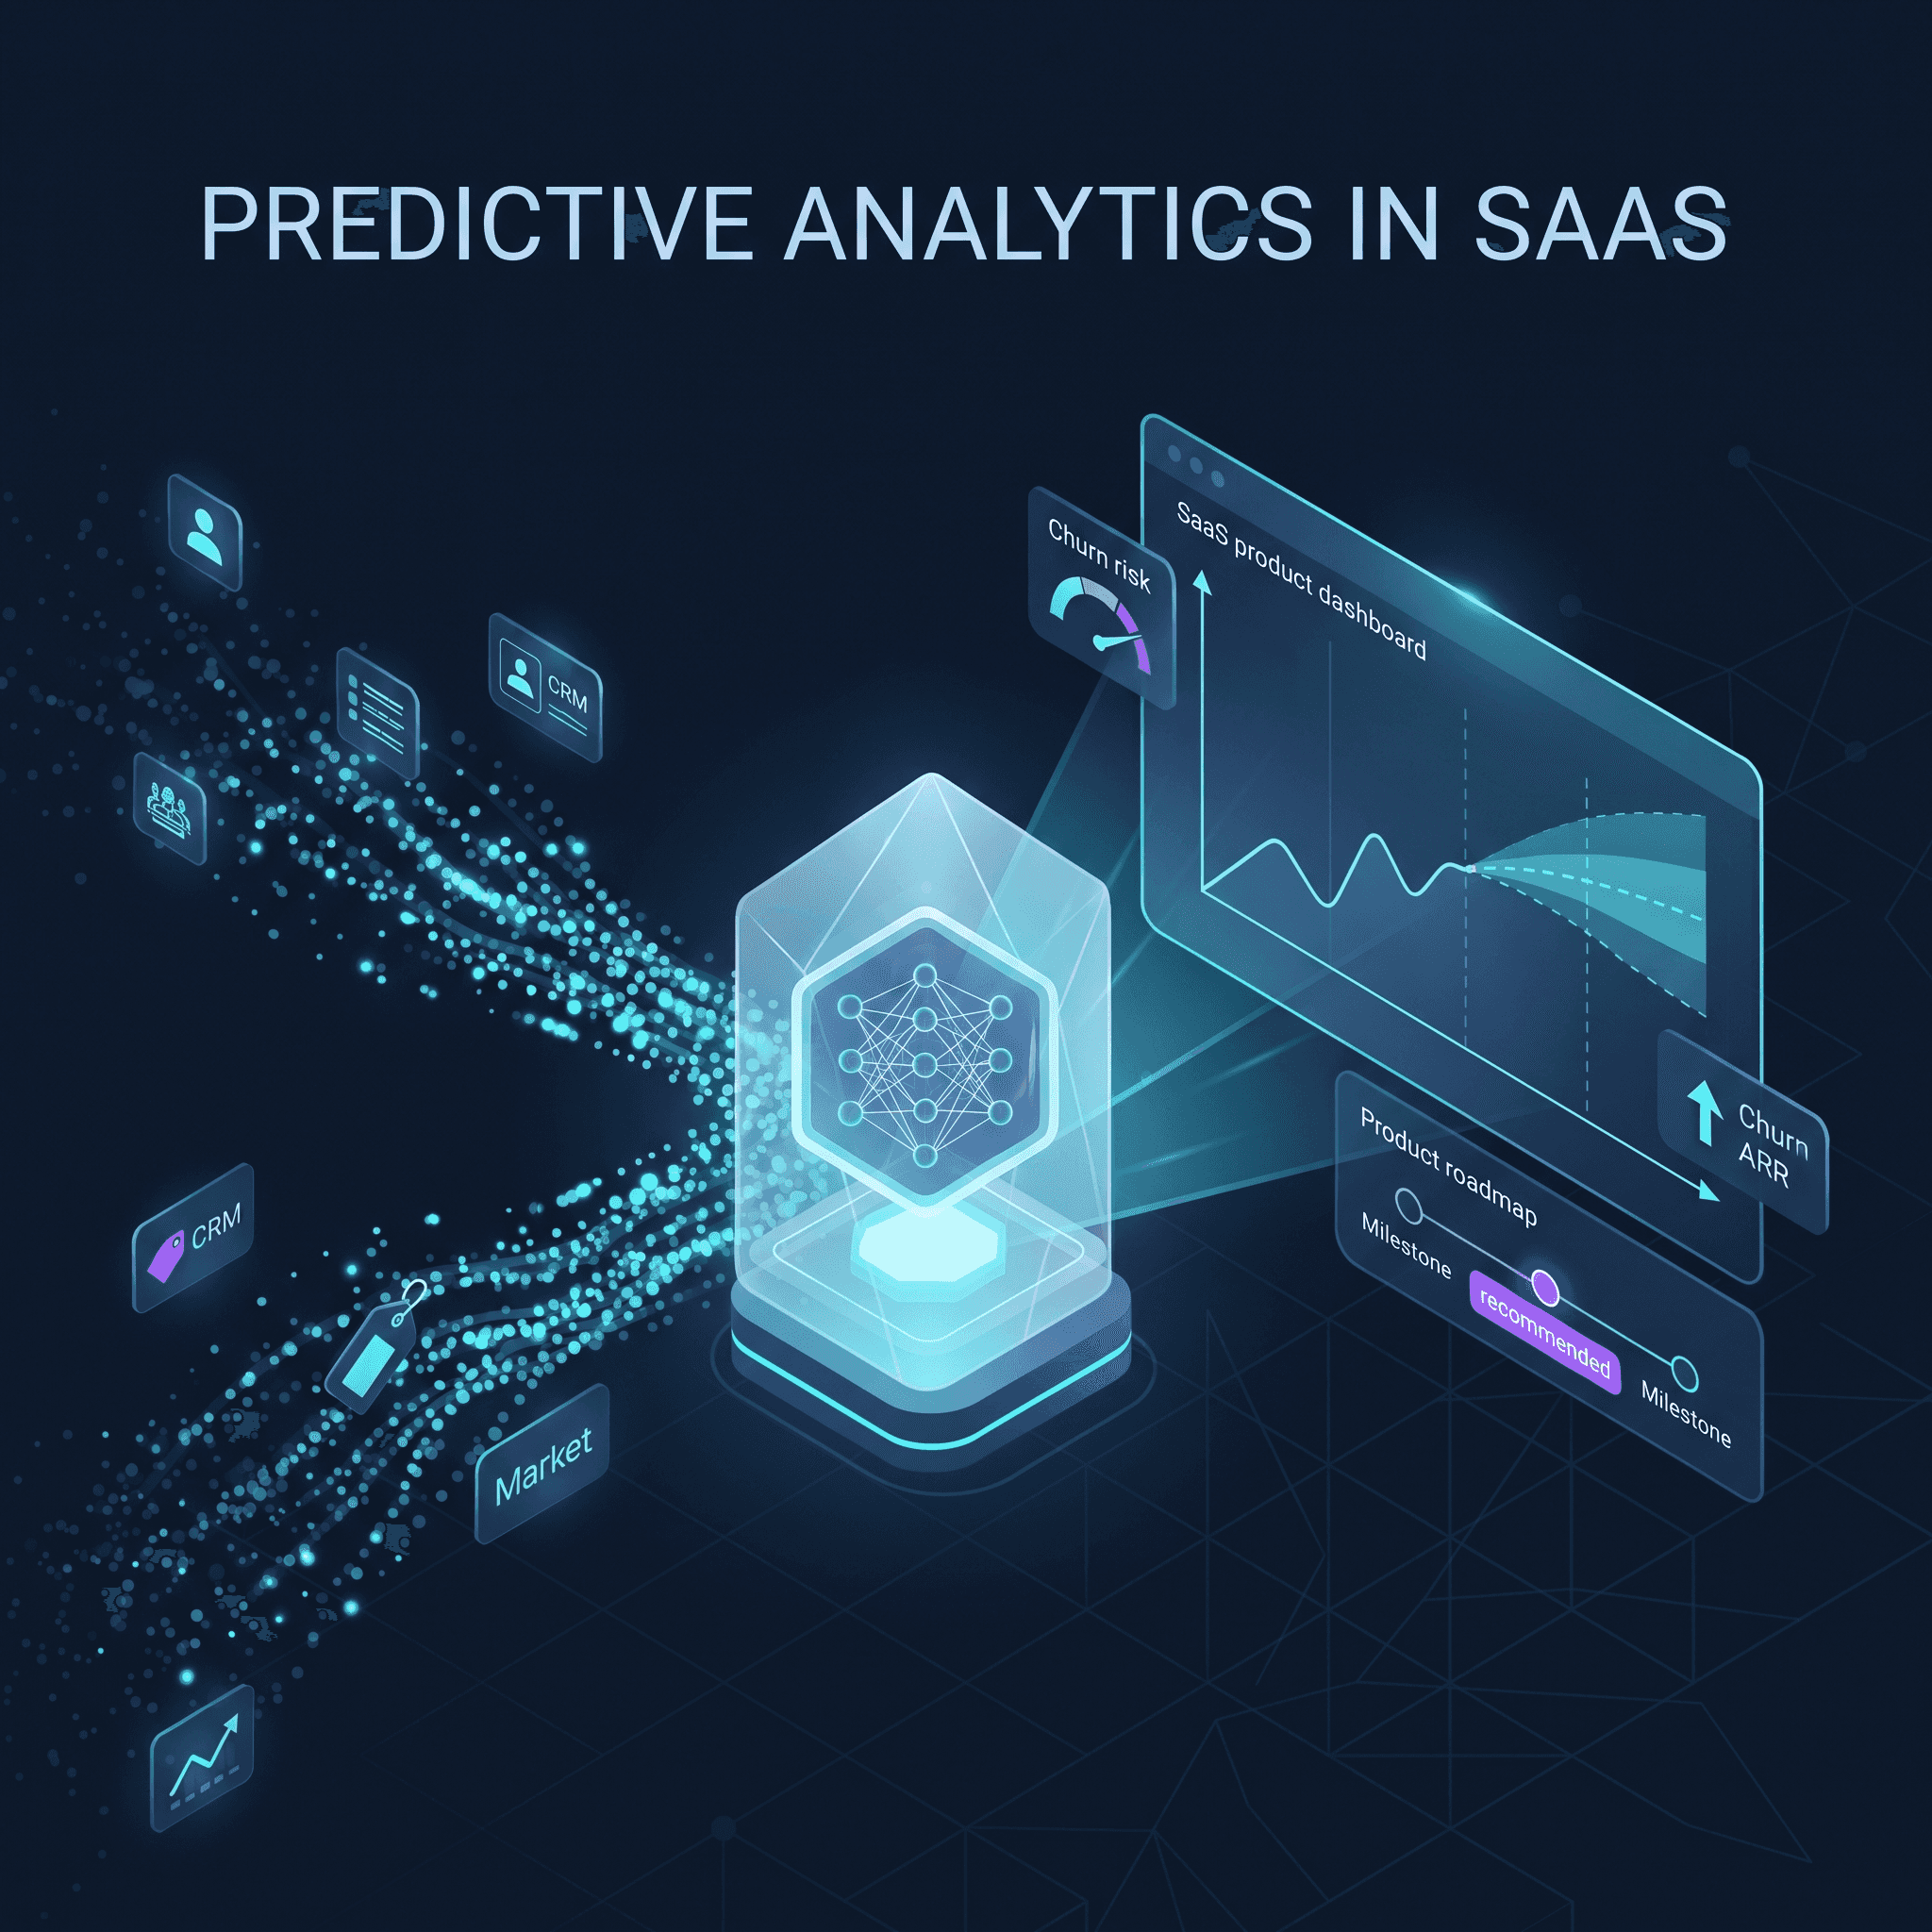
Prognozowanie odejść klientów (churn) to najczęściej opisywane zastosowanie analityki predykcyjnej w SaaS[5][9]. Przestało przy tym być sprawą wyłącznie zespołu opieki nad klientem i coraz częściej wpływa na priorytety w planie rozwoju produktu. Modele analizują sygnały z korzystania z produktu: częstotliwość logowań, to, jak głęboko klient używa poszczególnych funkcji, zmiany aktywności. Łączą je z danymi z umów i wyliczają wskaźnik ryzyka dla każdego konta. Wyobraź sobie, że duża część klientów planu Enterprise nie korzysta z nowej integracji API, a ich wskaźnik ryzyka rośnie. Sygnał jest czytelny. Albo trzeba uprościć wdrażanie tej funkcji, albo ona po prostu nie rozwiązuje realnego problemu klientów.
Drugi filar to sprzedaż dodatkowa i krzyżowa, czyli klienci przechodzący na wyższy plan lub dokupujący kolejne moduły[5]. Zamiast zgadywać, kto jest na to gotowy, modele wyłapują zachowania, które zwykle poprzedzają zmianę planu. Mogą to być na przykład zbliżanie się do limitu wywołań API, dodawanie kolejnych użytkowników do zespołu albo coraz częstszy eksport danych. Jeśli model wskaże takie konto z kilkutygodniowym wyprzedzeniem, jest czas na przemyślany, dopasowany kontakt zamiast zimnego telefonu.
Przewidywanie adopcji nowych funkcji domyka pętlę informacji zwrotnej[5]. Zanim funkcja trafi do wszystkich, analizujesz grupę testerów wersji beta. Sprawdzasz, które segmenty (według profilu firmy, sposobu korzystania z produktu, używanych technologii) przyjmują ją najszybciej, w którym miejscu procesu wdrażania ludzie odpadają i jak funkcja wpływa na retencję w pierwszych tygodniach. Dzięki temu poprawiasz pierwsze kroki użytkownika i komunikację jeszcze przed premierą, zamiast gasić pożar, gdy z nowej funkcji korzysta garstka klientów.
Najtrudniejszy przypadek to kanibalizacja przy zmianach cennika. Wprowadzasz nowy plan dla średnich firm, pomiędzy Starter a Enterprise. Ilu klientów Enterprise zejdzie na tańszy plan, ilu klientów Starter przejdzie wyżej i ile nowego przychodu zostanie na koniec? Podejście podobne do tego, które pokazał Kenvue, czyli połączenie historii premier, zmiennych wykonawczych i atrybutów produktu, pozwala oddzielić kanibalizację od rzeczywistego wzrostu[1]. Bez tego decyzję podejmuje się na wyczucie i łatwo przeoczyć spadek średniego przychodu na klienta (ARPU), który chowa się za rosnącą liczbą klientów.
Kluczem jest połączenie sygnałów z trzech warstw:
- korzystanie z produktu: strumień zdarzeń, flagi funkcji, długość i głębokość sesji,
- dane rynkowe: informacje o konkurencji, wzrost kategorii, sygnały intencji zakupowej,
- historia premier: co działało przy wcześniejszych wydaniach i które grupy klientów konwertowały.
Firmy, które trzymają te dane w osobnych pulpitach, tracą kontekst. Najlepsze wdrożenia idą krok dalej i budują systemy, które nie tylko prognozują, ale też rekomendują działania. Na przykład: „przesuń premierę funkcji X o kilka tygodni, bo segment Y ma niską przewidywaną adopcję" albo „przyspiesz wdrażanie kont z najwyższym wskaźnikiem ryzyka".
Architektura nowoczesnych systemów prognozujących
Współczesne systemy prognozujące w SaaS przeszły drogę od prostych wykresów trendów do platform decyzyjnych, które wpływają na plan rozwoju produktu, terminy premier i podział budżetu między funkcje. Łączą trzy warstwy danych: metryki korzystania z produktu (kliknięcia, sesje, adopcja funkcji), sygnały rynkowe (bieżące odczytywanie popytu, ruchy konkurencji) oraz atrybuty produktu wzbogacone przez AI. Te ostatnie to rozbudowane metadane, dzięki którym model może przewidzieć nie tylko czy funkcja się przyjmie, ale też w jakim stopniu odbierze użytkowników istniejącym funkcjom.
W praktyce wygląda to tak. Warstwa zbierania danych łączy strumień zdarzeń z produktu (Segment, Amplitude) z danymi z CRM i zgłoszeniami do pomocy technicznej. Potem, na etapie inżynierii cech (feature engineering), surowe zdarzenia dostają kontekst: kohortę użytkownika, etap cyklu życia klienta, plan cenowy, wskaźnik zaangażowania. Dopiero na tak przygotowanych danych uruchamia się modele uczenia maszynowego. Od prostych regresji, przez gradient boosting (XGBoost, LightGBM), po zespoły modeli łączące prognozy odejść, rozszerzeń i dopasowania produktu do rynku. W mniejszych firmach zwykle więcej daje staranne przygotowanie cech i jeden dobrze dostrojony model gradient boosting niż rozbudowany zespół modeli zbudowany na słabych danych.
Prognozowanie w czasie rzeczywistym zmienia pracę zespołów opieki nad klientem i RevOps. Zamiast czekać na koniec kwartału, opiekun klienta może dostać alert w rodzaju: „konto z ARR na poziomie 50 tys. USD ma 73% prawdopodobieństwa odejścia w ciągu 30 dni". Razem z przyczynami: spadek dziennej liczby aktywnych użytkowników o 40%, brak adopcji nowej funkcji, eskalacja zgłoszenia. To przyczyny są tu najcenniejsze, bo sam wynik bez wyjaśnienia rzadko prowadzi do działania. RevOps z kolei może widzieć prognozę lejka sprzedaży aktualizowaną na podstawie aktywności w produkcie, a nie tylko etapów szans sprzedażowych w CRM.
Najważniejsze jest przejście od analityki opisowej (co się stało), przez predykcyjną (co się stanie), do preskryptywnej, która podpowiada konkretne działanie. System nie kończy na komunikacie „wysokie ryzyko odejścia". Proponuje następny krok, na przykład: „uruchom ścieżkę wdrażania B dla segmentu Enterprise w okresie próbnym, bo historycznie lepiej konwertuje". Modele uczą się na wynikach testów A/B, domykają pętlę informacji zwrotnej i na bieżąco poprawiają decyzje produktowe. Prognozowanie przestaje więc być zadaniem wyłącznie działu finansów i staje się częścią rozwoju produktu[6]. Przewidujemy już nie tylko przychód, ale też to, którą funkcję zbudować w trzecim kwartale, żeby poprawić retencję w czwartym.
Luki w obecnym ekosystemie i kierunki rozwoju
Ekosystem rozwija się szybko, ale wciąż brakuje mu fundamentów potrzebnych do skalowania. Największy problem to niemal całkowity brak rzetelnych studiów przypadków z policzonym zwrotem z inwestycji. Kiedy pytasz, o ile wzrosła retencja po wdrożeniu prognozowania na kohortach, zwykle dostajesz marketingowe ogólniki zamiast twardych liczb. Typowy przykład: można przeczytać, że prognozy z arkuszy kalkulacyjnych osiągają 60–70% trafności, a systemy oparte na AI ponad 90%[7]. Brakuje jednak informacji, jak to mierzono, na jakich danych i w jakim horyzoncie.
Recenzowanych badań naukowych z ostatnich miesięcy, które dotyczyłyby właśnie SaaS, praktycznie nie ma. Wspomniane wcześniej podejście Kenvue to prezentacja konferencyjna z branży dóbr konsumenckich, a nie recenzowana publikacja, i dotyczy produktów sprzedawanych w sklepach, a nie subskrypcji[1]. Brakuje jego odpowiednika dla przychodu cyklicznego (MRR), przychodu z rozszerzeń czy metryk wzrostu napędzanego samym produktem (product-led growth).
Branży bardzo przydałyby się standardy prognozowania na kohortach i wnioskowania przyczynowego (causal inference). Dziś każdy dostawca definiuje „przewidywane odejście klienta" po swojemu. Jedni patrzą na okno 30-dniowe, inni na 90-dniowe, jeszcze inni mieszają sygnały behawioralne z danymi o firmie bez jasnej metodologii. Nie ma wspólnego języka do porównywania modeli, o powtarzaniu wyników nie wspominając.
Jednocześnie rośnie presja na integrację prognoz z resztą firmy. Nie mogą żyć w oderwaniu od procesów. Powinny być podłączone do systemów rozliczeń, zakupów i planowania finansowego[8], wpływać na plan rozwoju produktu, uruchamiać automatyczne scenariusze działań w opiece nad klientem i wspierać decyzje cenowe. Coraz tańsze subskrypcje otwierają dostęp do tych narzędzi mniejszym firmom, ale bez standardów jakości łatwo o więcej szumu niż sygnału.
Moim zdaniem największą luką jest brak pomostu między akademickim wnioskowaniem przyczynowym a modelami uczenia maszynowego działającymi produkcyjnie w SaaS. Potrzebujemy nie tylko lepszych modeli, ale też jasnych zasad decyzyjnych: kiedy prognoza powinna zmienić priorytet funkcji, a kiedy to zwykły szum w danych.
Praktyczne wnioski: lista kontrolna dla zespołów produktowych
1. Gotowość: czy masz fundament danych?
Zanim zainwestujesz w prognozowanie, sprawdź trzy obszary: historię premier i wdrożeń (dane w podziale na kohorty, najlepiej z co najmniej roku), sygnały z produktu (śledzenie zdarzeń na poziomie poszczególnych funkcji, a nie tylko odsłon stron) i sygnały rynkowe (informacje o konkurencji, trendy w segmentach). Bez tego budujesz na piasku.
Najskuteczniejsze modele łączą dane produktowe z rynkowymi. Przykład Kenvue pokazuje, jak dane sprzedażowe, historia premier i atrybuty produktów wzbogacone przez AI pozwalają przewidzieć wyniki pierwszego i drugiego roku razem z oszacowaniem kanibalizacji[1]. W SaaS odpowiednik wygląda tak: dane o korzystaniu z produktu + rynkowe punkty odniesienia + historia premier = prognoza rozszerzeń i odejść dla każdego segmentu.
2. Model wdrożenia: SaaS czy własna infrastruktura?
Skoro chmura ma już zdecydowaną większość tego rynku[4], sprawdzone narzędzia są dostępne od ręki, w abonamencie i bez inwestowania we własne serwery.
Instalacja na własnej infrastrukturze ma sens właściwie tylko przy ograniczeniach regulacyjnych albo wtedy, gdy masz własny zespół analityków danych i chcesz pełnej kontroli nad przygotowaniem cech. W większości produktów SaaS lepiej zacząć od gotowej platformy i przejść na własne modele dopiero wtedy, gdy standardowe przestaną wystarczać.
3. Priorytety: od czego zacząć?
Trzy zastosowania, od których najłatwiej zacząć[5][9]:
-
Prognozowanie odejść klientów. Wyłapuj klientów z grupy ryzyka z wyprzedzeniem i automatycznie uruchamiaj scenariusze działań w opiece nad klientem. Uwaga praktyczna: odejścia są zwykle rzadkie, więc sama trafność potrafi zmylić. Model, który zawsze odpowiada „klient zostanie", też osiągnie wysoki wynik. Lepiej patrzeć na precyzję i czułość.
-
Prognozowanie rozszerzeń. Przewiduj, które konta przejdą na wyższy plan w kolejnym kwartale. To bezpośrednio zasila lejek sprzedaży i pozwala dopasować proces wdrażania do ścieżki rozwoju klienta.
-
Adopcja funkcji. Szacuj, jaki odsetek każdego segmentu zacznie korzystać z nowej funkcji, zanim udostępnisz ją wszystkim. Mniej pracy pójdzie wtedy w funkcje, których nikt nie potrzebuje.
Zacznij od jednego zastosowania z jasno określonym miernikiem sukcesu, na przykład „spadek liczby utraconych klientów o 15% w ciągu 6 miesięcy". Nie buduj od razu platformy do wszystkiego.
4. Integracja: systemy muszą się ze sobą komunikować
Warstwa predykcyjna działa tylko wtedy, gdy łączy analitykę produktową (Amplitude, Mixpanel), CRM (Salesforce, HubSpot) i hurtownię danych (Snowflake, BigQuery). Jeśli te systemy nie mają wspólnych identyfikatorów klientów i spójnych schematów zdarzeń, zacznij od uporządkowania danych. Inaczej modele będą się uczyć na błędnie połączonych tabelach.
Gotowe platformy analityczne automatyzują cały ten proces: pobieranie danych z wielu źródeł, przygotowanie cech, regularne odświeżanie modeli i dostarczanie wyników do narzędzi, z których korzysta zespół. Szukaj dostawców z gotowymi konektorami do systemów, których używasz. Pisanie własnych procesów ETL od zera to pułapka, która potrafi zjeść miesiące.
5. Kompetencje: wspieranie decyzji a klasyczne BI
Klasyczne BI mówi, co się stało. Narzędzia do wspierania decyzji mówią, co zrobić. Zespół produktowy potrzebuje ludzi, którzy rozumieją wnioskowanie przyczynowe (co naprawdę wpływa na retencję, a co jest tylko korelacją), projektowanie eksperymentów (jak sprawdzać prognozy testami A/B) i interpretację modeli (dlaczego model wskazał akurat ten segment).
Nie potrzebujesz zespołu doktorów. Na początek wystarczy menedżer produktu, który dobrze zna SQL i podstawy statystyki, oraz inżynier analityki, który swobodnie pracuje z dbt i przygotowaniem cech. Zaawansowane modele, takie jak prognozowanie odejść czy wartości klienta w czasie (LTV), można kupić u dostawców SaaS. Samodzielnie warto budować tylko logikę specyficzną dla własnej branży.
6. Mierniki sukcesu: jak liczyć zwrot z inwestycji
Mierz na trzech poziomach.
Jakość modelu: precyzja i czułość, kalibracja prawdopodobieństw i przede wszystkim porównanie z prostym punktem odniesienia (np. „wynik z ostatniego kwartału × 1,1"). Jeśli model nie jest od niego wyraźnie lepszy, nie wdrażaj go.
Wpływ na pracę zespołu: ile dni mija od sygnału do decyzji, jaki odsetek zespołu faktycznie korzysta z prognoz i jak szybko model uczy się na nowych danych.
Wyniki biznesowe: czy funkcje wybrane dzięki modelowi mają wyższą adopcję, ile ARR przyniosły działania nastawione na rozszerzenia, ile kosztów udało się uniknąć dzięki mniejszej liczbie odejść i niższym wydatkom na pozyskanie klientów w miejsce utraconych.
Ustal punkt wyjścia przed wdrożeniem i porównuj wyniki kwartał do kwartału. Jeśli po 6 miesiącach nie widzisz mierzalnej poprawy retencji ani przychodu z rozszerzeń, zmień podejście albo zamknij projekt. Prognozowanie dla samego prognozowania to strata czasu i pieniędzy.
Bibliografia
- Analytics and Forecasting 2026 – Marketing Science Institute (sesja „Closing the Innovation Forecast Gap: An AI/ML Approach to New Product Forecasting and Incrementality at Kenvue", 14.09.2026)
- Predictive Analytics Market Size, Share and Trends 2026 to 2035 – Precedence Research
- SaaS-Based Business Analytics Market Size, Share and Trends 2026 to 2035 – Precedence Research
- Predictive Analytics Market Size, Share | Industry Report 2034 – Fortune Business Insights
- 2026 SaaS Predictive Analytics: Use Cases & More – Qrvey
- Predictive AI for SaaS Companies: Growth, Churn Prediction & Revenue Forecasting – Vegavid
- AI-Powered Revenue Forecasting: Machine Learning for SaaS Predictions – MRR.ai
- How SaaS AI Analytics Improves Forecasting for Growth, Retention, and Operations – SysGenPro
- Use Cases of Predictive Analytics in SaaS Platforms – Adlega
Komentarze
Komentarze obsługuje Cusdis. Widżet ładuje się dopiero po kliknięciu.